
글로벌 데이터 아키텍처 논의와 시장 분석 시나리오로 살펴본 기업의 준비 과제
“이번 가을·겨울, 우리 브랜드가 집중할 경량패딩 고객과 상품 기회를 찾아줘.”
AI 에이전트가 이 요청에 답하려면 무엇이 필요할까요. 소비자의 관심을 확인하고, 자사 판매와 재고를 조회하고, 시장 보고서와 고객 리뷰를 검토해야 할 겁니다. 그리고 이를 종합한 기획안에는 담당자가 확인할 수 있는 데이터 근거도 있어야 할 겁니다.
문제는 자료가 서로 다른 형태로 흩어져 있다는 점입니다. 판매 실적은 데이터베이스에, 상품 설명은 상품관리 시스템에, 시장 보고서는 PDF에 담겨 있습니다. 또 소비자의 관심을 보여주는 검색 데이터와 소셜 데이터는 외부 서비스에서 가져와야 합니다.
따라서 기업이 풀어야 할 과제도 구체적입니다. 어떤 경로로 데이터에 접근할 것인가. 서로 다른 자료의 의미를 어떻게 판단할 것인가. 분석에 사용한 근거와 관계를 어떤 구조로 남길 것인가.
이 글에서는 세 개의 아티클로 부터 데이터 과제를 정리하고, 리스닝마인드 DaaS를 활용한 시장 기회 분석 시나리오에 적용해 봅니다.
| 구분 | AI agents speed up development | Your AI agent aced the demo | The Rise of the Modern Agentic Data Stack |
|---|---|---|---|
| 출처 | The New Stack | The New Stack | SDG Group |
| 핵심 주제 | 데이터 접근 경로(Access)의 인프라적 병목 | 데이터 품질과 거버넌스(Governance)의 위험성 | 데이터 파이프라인 자체의 에이전트화(Self-Healing) |
| 비유적 상황 | 앱은 빨리 만드는데 데이터 연결관(API)을 짜느라 개발자가 멈춤 | 실험실(데모)에선 똑똑했던 AI가 실전 데이터에선 사고를 침 | 기존 데이터 파이프라인이 너무 ‘잘 부러져서(Brittle)’ 예상치 못한 변화에 멈춤 |
| 주요 원인 | 수동 API 구축, 파편화된 데이터베이스 인프라 | 파편화되고(Fragmented), 낡고(Stale), 통제되지 않는 데이터 | 환경이나 소스 데이터가 조금만 바뀌어도 에러를 내는 규칙 기반 파이프라인 |
| 해결 방향 | 통합 API 레이어 및 MCP 같은 표준 프로토콜 도입 | 강력한 데이터 거버넌스 및 비즈니스 맥락(Context) 확립 | AI가 파이프라인의 에러를 관찰하고 스스로 고치는 자가 치유 데이터 스택(Modern Agentic Data Stack) 도입 |
데이터 접근: 필요한 자료를 어떤 경로로 가져올 것인가
The New Stack의 글 「AI agents speed up development — data access slows them down」은 에이전트 개발과 데이터 접근 사이의 병목을 다루고 있습니다.
이 글은 AI 에이전트가 코딩을 아무리 잘해도, 정작 일을 수행할 ‘데이터(맥락)’에 접근하는 과정이 막혀있다면 무용지물이라는 점을 강조합니다.
- 가장 큰 병목은 ‘데이터 접근’: AI 에이전트는 코드 작성 속도를 획기적으로 높여주지만, 기업의 내부 데이터베이스나 API에 안전하고 빠르게 접근하지 못해 실질적인 성능을 내지 못하고 있습니다.
- 전통적인 통합 방식의 한계: 과거처럼 개발자가 AI를 위해 일일이 API와 커넥터를 수동으로 구축하는 방식은 너무 느리고 확장이 불가능합니다.
- 새로운 해결책, MCP: 앤트로픽(Anthropic)이 개발한 MCP(Model Context Protocol) 같은 오픈소스 프로토콜이 중요하게 대두됩니다. MCP는 AI 에이전트와 데이터 소스 간의 안전하고 표준화된 양방향 연결을 제공하여 데이터 병목을 해결하는 열쇠로 제시됩니다.
기업 업무에 적용하면, 에이전트마다 수행할 업무에 맞는 조회 경로와 권한을 제공해야 한다는 뜻이다. 시장 기회 분석에 상품별 판매량은 필요할 수 있지만, 고객 개개인의 연락처까지 필요한 것은 아닙니다. 또한 데이터마다 가져오는 방법이 달라야 한다. 숫자를 계산할 때는 데이터베이스를 조회하고, 보고서의 설명을 찾을 때는 문서를 검색합니다.
예를 들어 경량패딩 분석에는 다음과 같은 연결을 설계할 수 있습니다.
| 데이터 | 접근 방법 | 가져올 항목 |
|---|---|---|
| 외부 검색 데이터 | 제공 범위에 맞춘 DaaS API·연동 | 키워드, 국가, 월별 검색량, 관련 검색어, 검색 여정 |
| 내부 판매·재고 | 권한이 제한된 데이터베이스 조회 | 상품번호, 판매일, 판매수량, 취소·반품, 재고 |
| 내부 상품 정보 | 상품관리 시스템 조회 | 상품번호, 가격, 충전재, 무게, 핏, 길이, 사이즈 |
| 고객 리뷰·문의 | 상품번호로 연결된 리뷰 조회·문서 검색 | 작성일, 원문, 대상 상품, 불편 유형 |
| 외부 시장 보고서 | 이용 권한이 있는 문서에서 관련 부분 검색 | 보고서명, 발행일, 국가, 조사 기간, 페이지, 근거 문장 |
여기서 접근 권한은 실제 조회 단계에서 적용돼야 합니다. 에이전트에 “허용된 정보만 사용하라”고 지시하는 것에 더해, 조회 도구 자체가 허용된 데이터만 반환하도록 구성하는 것입니다.
시장 보고서도 연결할 수 있습니다. 이용 권한이 있는 보고서를 문단과 표 단위로 검색할 수 있게 준비하고, 질문에 필요한 부분을 찾아 답변의 근거로 제공합니다. 이 때 검색 증강 생성, RAG이 활용되기도 합니다.
예를 들어 “국내 겨울 의류의 구매 기준을 찾아줘”라는 요청에는 해당 국가·상품 범주·조사 기간에 맞는 부분을 검색하게 합니다. 표를 가져온다면 제목, 단위, 주석도 함께 보존해야 합니다. 수치만 떼어오면 응답자 비율인지, 매출 비중인지 알 수 없기 때문입니다.
맥락 판단: 가져온 데이터가 무엇을 의미하는가
두 번째 아티클 「Your AI agent aced the demo. Your data may still derail it.」 에서는 데이터 병목을 해결하기 위한 과제로 통합된 비즈니스 컨텍스트 계층을 제안합니다.
기업에서 이를 구현하려면 먼저 업무 용어와 계산 규칙을 명확히 해야 한다. ‘판매량’이 주문수량인지, 취소·반품을 제외한 수량인지에 따라 분석 결과가 달라진다. ‘경량패딩’에 어떤 상품을 포함하는지도 정해야 한다.
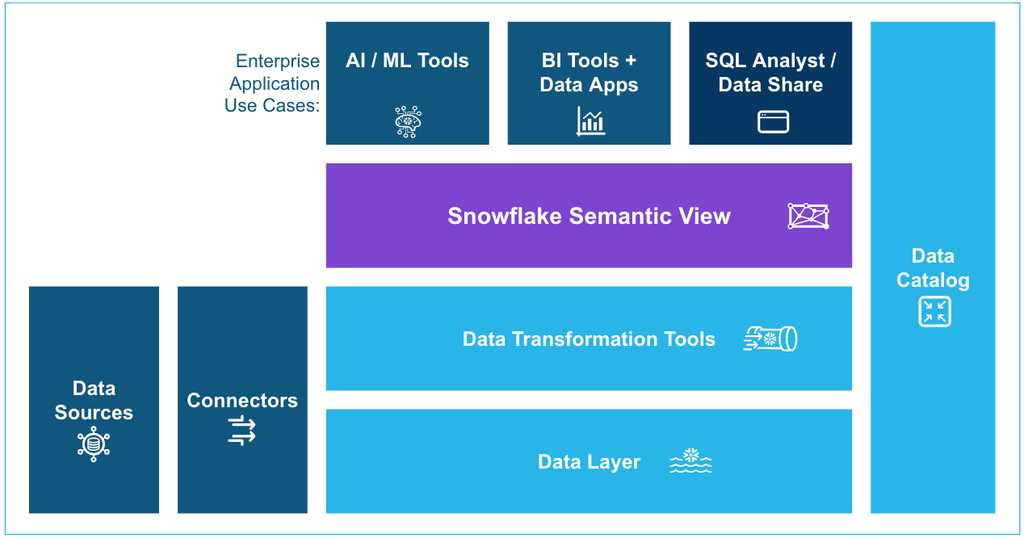
이러한 정의를 데이터와 연결하는 것이 의미 계층, 즉 시맨틱 레이어다.
Snowflake의 Semantic Views에서 사업 지표와 분석 차원, 데이터 간 관계를 정의하고 에이전트가 활용할 수 있도록 하는 구현 사례를 보여주고 있습니다. 물리적인 테이블과 열 이름에 업무상 의미를 부여해 지표를 일관되게 해석하도록 돕는다고 합니다. Snowflake 공식 문서
만약 당신이 경량패딩 분석을 한다고 하면, 다음 항목을 사전에 정의할 수 있습니다.
| 항목 | 필요한 정의 |
|---|---|
| 상품 범주 | 경량패딩에 포함할 상품과 분류 기준 |
| 순판매수량 | 취소·반품을 반영하는 계산식 |
| 분석 단위 | 상품별·사이즈별·월별 등 집계 기준 |
| 검색 변화 | 전월 대비와 전년 동월 대비 구분 |
| 비교 범위 | 국가, 채널, 기간, 가격대 |
| 타깃 해석 | 검색어에 나타난 구매 대상과 실제 검색자 구분 |
예를 들어 ‘키즈 경량패딩’ 검색은 어린이용 상품에 대한 관심을 보여줄 수 있지만 검색 주체가 어린이라는 뜻은 아닐 것입니다. 검색량 역시 고유 검색자 수나 구매 건수와 다릅니다. 이런 데이터 해석의 정의가 필요하다는 것입니다.
외부 자료의 조건도 맞춰야 합니다. 해외 시장 보고서의 전체 아우터웨어 전망을 국내 경량패딩 수요의 직접적인 증거로 사용하기는 어렵습니다. 해당 보고서는 배경 설명에 활용하고, 국내 상품 기회는 범위가 맞는 데이터로 추가 확인해야 합니다.
맥락 판단의 핵심은 AI가 그럴듯한 이야기를 만들게 두면 안 됩니다. 지표의 정의와 자료의 적용 범위를 확인하고, 관찰한 사실과 추론을 구분하는 데 있습니다.
구조화: 숫자와 문서, 관계를 어떻게 연결할 것인가
SDG Group의 「The Rise of the Modern Agentic Data Stack – Part 1」은 에이전틱 데이터 스택을 바라보는 컨설팅사의 관점을 제공하고 있습니다. 정량적 성과 자료보다는 기업의 데이터 구성을 검토하는 관점으로 살펴볼 수 있습니다.
실제 설계에서는 모든 자료를 하나의 저장소로 모두 옮길 필요는 없습니다. 데이터의 성격에 따라 저장하고, 분석에 필요한 연결을 만드는 구성이 가능합니다.
| 구성 | 담을 내용 | 역할 |
|---|---|---|
| 정형 데이터와 의미 계층 | 판매·재고·검색량, 계산식, 분류 기준 | 정확한 계산과 비교 |
| 문서 검색 인덱스 | 보고서·리뷰·상품 설명의 원문과 출처 | 관련 근거 검색 |
| 지식 그래프 | 상품·속성·소비자 표현·근거 사이의 관계 | 흩어진 정보 연결 |
| 분석 결과 기록 | 관찰 사실, 가설, 반대 근거, 검증 계획 | 검토와 후속 분석 |
이 가운데 지식 그래프는 다음과 같이 상품과 자료 사이의 관계를 표현하는 데 활용할 수 있습니다.
- 상품 A는 조끼형 경량패딩이다.
- 리뷰 B는 상품 A를 평가하며, 겹쳐 입을 때의 불편을 언급했다.
- 보고서 C의 특정 문단은 레이어링을 다룬다.
- 기회 가설 D는 리뷰 B와 보고서 C를 근거로 작성됐다.
이때 공식 상품 속성, 소비자의 의견, 에이전트의 추론을 구분해서 저장할 필요가 있습니다. 리뷰의 “가볍다”라는 표현은 제품의 공식 무게 측정값과 다릅니다. 보고서가 레이어링을 언급했다고 해서 상품 A의 판매 가능성이 입증되는 것도 아닙니다.
각 관계에 출처와 날짜, 원문 위치, 검토 상태를 붙이면 담당자가 연결의 타당성을 확인할 수 있게 됩니다.
Microsoft GraphRAG, Snowflake Semantic Layer 공개 문서를 참조해 볼 수 있습니다.
| 기술 요소 | Microsoft GraphRAG | Snowflake 의미 계층 (Semantic Layer) |
|---|---|---|
| 주요 대상 | 비정형 데이터 (텍스트 문서, 보고서 등) | 정형/반정형 데이터 (DB 테이블, 데이터 웨어하우스) |
| 핵심 기능 | 문서 내 개체·관계 추출 및 집단(Community) 요약 | 지표(Metrics) 및 데이터 관계의 일관된 정의(Single Source of Truth) |
| AI의 역할 | 흩어진 정보의 맥락을 연결하여 종합적 검색(Global Query) 지원 | AI 에이전트가 데이터베이스를 조회할 때 오해 없이 정확한 SQL을 짜도록 가이드 |
| 주의점 | 자동 추출된 관계의 정확성 및 환각(Hallucination) 검토 필요 | 비즈니스 로직 변화에 따른 지속적인 정의 업데이트 필요 |
Microsoft의 GraphRAG는 문서에서 개체와 관계를 추출하고, 관련 집단의 요약을 만들어 검색에 활용합니다. 여러 문서에 흩어진 내용을 연결하는 방법을 보여줍니다. 단, 자동으로 추출한 관계의 정확성은 별도로 검토해야 합니다. Microsoft GraphRAG 공식 문서
Snowflake의 의미 계층과 Microsoft의 GraphRAG는 서로 다른 문제를 다루고 있습니다. 전자는 지표와 데이터 관계의 일관된 정의에, 후자는 문서 속 정보의 연결과 검색에 초점을 둡니다. 기업은 업무에 필요한 범위에서 이를 조합할 수 있습니다.
적용 예시: 시장에서 상품 기회를 찾는 에이전트
이제 리스닝마인드 DaaS로 외부 검색 데이터를 연결하고, 내부 상품·판매 정보와 함께 분석하는 상황을 가정해봅시다. 다음은 실제 고객 도입 사례가 아닌 활용 시나리오입니다.
첫 단계: 시즌 관심과 세부 탐색 조건을 확인한다
- 리스닝마인드에서 조회한 국내 ‘경량패딩’ 검색량은 2025년 9월 89,300건에서 10월 445,100건으로 약 5배 증가했다. 2026년 9월 검색량은 106,300건으로 전년 동월보다 약 19% 늘었다.
- 관련 검색어에는 ‘여성 경량 패딩’, ‘남자 경량 패딩’, ‘키즈 경량패딩’, ‘경량패딩 조끼’, ‘경량 패딩 추천’과 여러 브랜드명이 포함돼 있었다.
여기까지 확인한 사실은 두 가지입니다. 시즌 진입 시점에 검색 관심이 크게 증가했고, 소비자는 타깃과 제품 형태, 브랜드를 구분해 탐색하고 있었다는 점입니다. 하지만 여성용이나 조끼형 상품의 성장까지 확인한 것은 아닙니다. 에이전트는 해당 세부 검색어의 월별 검색량과 전년 동월 변화 등을 추가 조회해야 합니다.
두 번째 단계: 외부 관심과 내부 성과를 같은 기준으로 비교한다
예를 들어 여성용 상품을 검토한다면 내부 상품 목록에서 해당 상품번호를 가져옵니다. 이어 동일한 기간의 판매, 재고, 할인, 광고 집행 정보를 대조합니다.
판매 부진을 해석할 때도 조건을 구분해야 합니다. 재고가 없어서 판매하지 못한 것인지, 충분한 재고에도 구매가 적었던 것인지에 따라 다음 행동이 달라집니다. 할인 행사로 판매가 증가했다면 상품 선호만으로 설명할 수 없습니다.
리뷰와 문의는 상품번호로 연결해 확인합니다. 길이, 핏, 사이즈 관련 표현이 반복되는지 살피고, 필요하면 담당자가 검토한 기준으로 유형을 분류합니다.
시장 보고서는 이 과정에서 외부 배경을 보완하게 됩니다. 국가와 조사 기간, 상품 범위가 맞는 근거를 검색하고, 내부 데이터와 일치하는 부분과 다른 부분을 함께 기록합니다.
세 번째 단계: 근거가 있는 가설과 검증 계획을 만든다
아래는 추가 분석을 통해 검토할 수 있는 가설입니다. 현재 검색 결과만으로 확인된 상품 기회는 아닙니다.
| 기회 가설 | 필요한 추가 근거 | 실행·검증 예시 |
|---|---|---|
| 여성용 제품의 핏·길이 선택 강화 | 관련 검색 변화, 상품별 문의·반품 사유 | 핏·길이 비교 정보 제공 후 전환과 문의 변화 확인 |
| 조끼형 제품의 활용 제안 | 함께 탐색하는 상품·사용 상황, 자사 제품 적합성 | 코디 콘텐츠·연계 상품 구성 테스트 |
| 키즈 제품의 선택 정보 강화 | 사이즈·관리 관련 탐색과 고객 문의 | 사이즈 안내 개선 후 반품·문의 변화 확인 |
| 브랜드 비교 단계의 정보 보강 | 가격·기능 비교 검색, 자사 제품 속성 | 무게·충전재·가격 비교 정보 제공 후 효과 확인 |
최종 제안에는 다음 항목을 함께 보고합니다.
- 관찰 사실: 어떤 데이터에서 무엇을 확인했는가.
- 기회 가설: 그 사실을 바탕으로 무엇을 검토할 것인가.
- 자사 대응 근거: 적합한 상품과 재고, 설명 자료가 있는가.
- 불확실성: 부족하거나 서로 일치하지 않는 근거는 무엇인가.
- 다음 검증: 무엇을 실행하고 어떤 결과로 평가할 것인가.
이 구조라면 담당자는 제안의 결론뿐 아니라 판단 과정을 함께 검토할 수 있게 됩니다. 다음 시즌에는 실행 결과를 다시 연결해 가설을 수정할 수도 있습니다.
에이전트에 데이터를 연결하기 전 정해야 할 것
이 사례가 보여주는 것은 데이터가 많아도 판단 기준과 연결 방식이 반드시 필요하다는 점입니다.
기업은 먼저 조회할 데이터와 권한을 정해야 합니다. 이어 상품 범주와 지표 계산식, 분석 기간을 정의해야 합니다. 보고서와 리뷰는 출처를 보존해 검색할 수 있게 준비하고, 필요한 경우 지식 그래프로 관계를 연결할 수 있습니다.
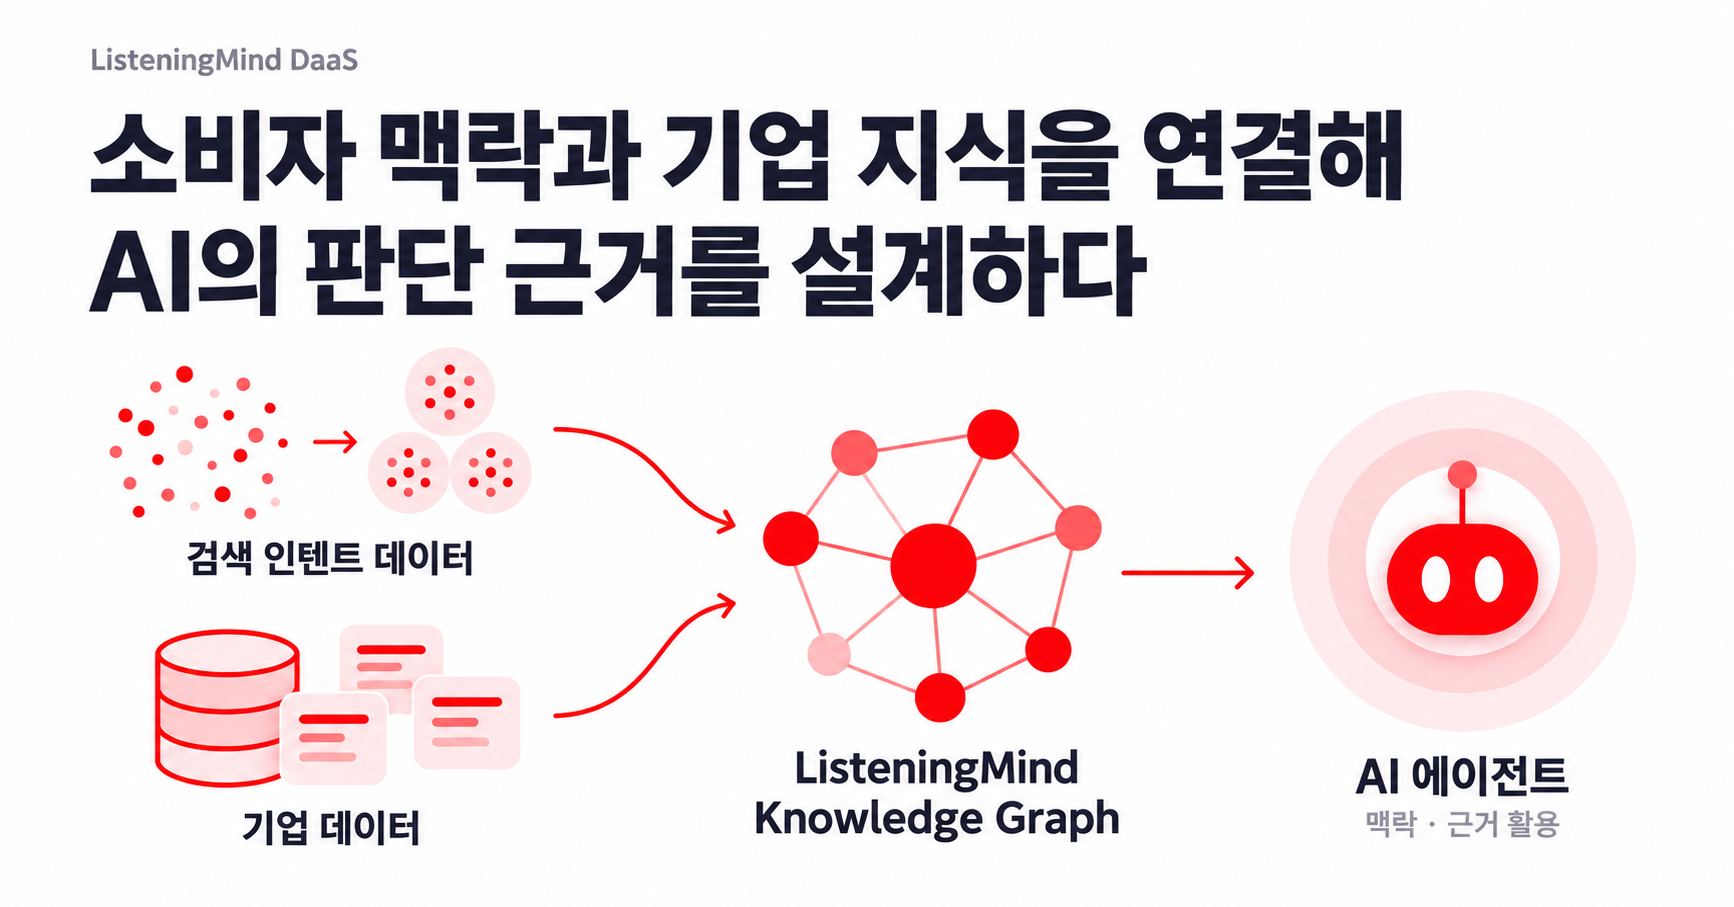
리스닝마인드 DaaS는 이 구조에서 외부 소비자 신호를 공급하는 역할을 맡습니다. 검색 관심과 탐색 맥락을 내부 상품·판매 정보에 대조할 수 있게 합니다. 내부 데이터의 의미 계층이나 기업 전체의 권한 관리는 별도로 설계한 후 리스닝마인드로 구축한 지식그래프, 즉 상품 속성, 소비자 표현, 데이터 근거(키워드, 검색량, 트렌드, SERP, AI Overview 등)와 연결합니다.
에이전틱 AI의 데이터 준비는 3가지로 요약할 수 있습니다. 조회할 수 있는 데이터를 마련하고, 해석할 기준을 정의하며, 제안의 근거를 추적할 수 있게 연결하는 일입니다. 그 위에서 기업은 에이전트의 제안을 실행 가능한 가설로 검토하고, 실제 고객 반응으로 평가할 수 있습니다.